Lightricks 发布 LTX-2.5,支持 image-to-video 任务
Lightricks 在 HuggingFace 上发布了 LTX-2.5 模型,任务为 image-to-video。发布日期为 2026 年 7 月 23 日,该模型有 39 次下载和 124 个“喜欢”标记。代码已开源,详情见 模型页面。
方法的工作原理。示意图根据这篇简讯绘制。
Switch to the English version? It is the same page at the same address, with a language prefix.
Other languages: Русский
 AnyTalk 为任意角色生成 3D 语音动画,无需动画数据研究人员推出了 AnyTalk——一种为任意角色生成 3D 语音动画的方法,既不需要动画数据,也不需要手动绑定。取而代之的是,作者在目标角色的渲染结果上对现成的 video diffusion model 进行微调。
 HuggingFace 新模型 h3-vbvr 解决 image-to-video 任务2026年8月18日,HuggingFace 上发布了模型 Patarapoom/h3-vbvr,任务为 image-to-video。发布时已有 2434 次下载,0 个「喜欢」标记。代码已开源。这意味着什么 该模型属于 te
 DSAQuant 提出考虑去噪阶段的视频扩散量化方法arXiv 论文作者指出,常规的 quantization-aware training 会破坏视频模型的细节和锐度,尽管整体构图和运动得以保留。原因在于量化未区分去噪阶段:早期步骤
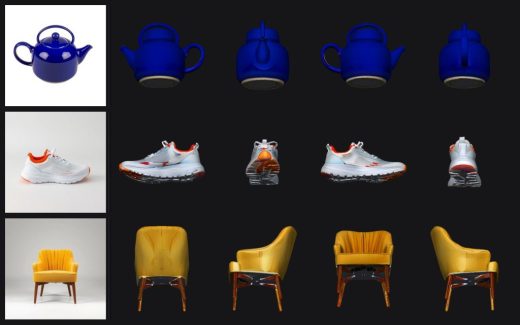 Hunyuan3D 2.1 无需 CUDA:更新新增 ROCm 和 PBR 纹理Hunyuan3D 2.1 的无 CUDA 硬件移植版于 2026 年 8 月 9 日更新,新增了此前完全没有的功能:通过 ROCm(Linux 和 Windows)支持 AMD 显卡,以及 PBR 纹理。之前的版本描述中明确声称