神经网络新闻:3D、视频及可在自己硬件上运行的语言模型
关于工具变化的简讯:发布了新版本、许可证变更、新增对其他平台的支持。不转述新闻稿:如果某个说法无法关联到代码仓库、模型页面或官方网站,就不会发布简讯。
文章
93 篇文章 AnyTalk 为任意角色生成 3D 语音动画,无需动画数据研究人员推出了 AnyTalk——一种为任意角色生成 3D 语音动画的方法,既不需要动画数据,也不需要手动绑定。取而代之的是,作者在目标角色的渲染结果上对现成的 video diffusion model 进行微调。
 ES3D 通过语义嵌入实现 3D 组件级编辑arXiv 上发布了 ES3D 的研究成果——一个用于 3D 资产组件级编辑的框架。作者提出将语义直接嵌入 3D 空间:多视角语义特征被投影到体素化的空
 音视频生成获得兼顾音画同步的加速方法论文《Efficient Audio-Visual Generation via Synchrony-Aware Cross-Modal Sparse Attention》的作者提出了一种加速推理的方法,适用于同时生成视频和音频的模型。他们发现,双向 cross-attenti
 Qwen-Video-Edit 将图像编辑模型转变为视频编辑器阿里巴巴发布了 Qwen-Video-Edit——一种将基于指令的图像编辑模型 Qwen-Image-Edit 应用于视频、而无需从头训练视频生成基础模型的方法。Wan 2.1 视频编码器的潜在帧被分解为
 MegaParts 将 3D 对象按部件生成扩展至 300 个零件研究人员推出了 MegaParts——一个用于生成分解为语义部件的 3D 对象的框架。该方法的核心是一个向量量化分词器,它将每个部件的几何形状压缩为具有自适应长度的离散令牌。
 V-RAE 提出视频生成潜空间的新方法arXiv 上发布了 V-RAE 的研究论文,作者重新审视了视频自编码器潜空间的结构。他们不再仅针对逐像素重建来优化潜空间,而是构建紧凑的生成式潜空间。
 Alaya-EVOKE 发布线性扩展的长交互世界生成方法arXiv 上发布了 Alaya-EVOKE 的研究成果,作者在该工作中解决了长交互世界生成的问题。他们将场景状态提取到按相机索引的外部存储库中,并针对 long-horizon supervision 重新构建教师模型:分
 LTX-2.5 已发布至 HuggingFace,支持 text-to-video 任务HuggingFace 上发布了模型 comfyicu/LTX-2.5,支持 text-to-video 任务。发布日期为 2026 年 8 月 13 日,该模型已有 3630 次下载。详情请见模型页面。这意味着什么 在我们关于 3D 和视频的 AI 工具指南中,目前不
 HuggingFace 上线 LTX-2.5 模型,支持 text-to-video 任务HuggingFace 上发布了模型 yuvraj108c/LTX-2.5,支持 text-to-video 任务。发布日期为 2026 年 8 月 12 日。截至本简讯发布时,该模型有 1445 次下载和零个“喜欢”标记。代码已开源。这意味着什么 在指南
 基于扩散的视频去反射新方法简讯研究人员发布了论文 From Synthesis to Removal: Physics-Grounded Reflection Simulation and Diffusion-Based Video Dereflection,该论文于 2026 年 8 月 12 日发表。作者描述了一个由三个组件…
 LTX-Video 和 CogVideoX 通过合成视频获得新的 zero-shot 字幕生成方法研究人员在 arXiv 上发表了论文《Watching Synthetic Videos: Aligning Cross-modal Representations with Visual Synthesis for Zero-shot Video Captioning》,其中提出了用于 zero…
 Minimax-H3-fl2va-ref2va-hybrid-models:HuggingFace 上的新 text-to-video 模型2026年8月11日,HuggingFace 上发布了模型 smhfacct/Minimax-H3-fl2va-ref2va-hybrid-models,任务为 text-to-video。截至发布时,该模型下载量为零,有 27 个“喜欢”标记。开发者既未说明架构,也未说明
- Latent-to-4D 直接从视频潜变量生成4D场景,无需中间RGB步骤论文《Beyond Pixels: From Video Priors to 4D Worlds》的作者提出了 Latent-to-4D 方法,该方法跳过了 RGB 视频重建阶段,直接从视频模型的最终去噪潜变量预测动态 3D 场景。该方法基于
 Sci-VBench:生成模型视频科学可信度基准Sci-VBench 作者提出了一个用于评估科学领域视频生成的基准。该基准包含 1 253 个由专家标注的示例,涵盖自然科学、医疗健康、人文与社会科学以及工程学等 60 个学科
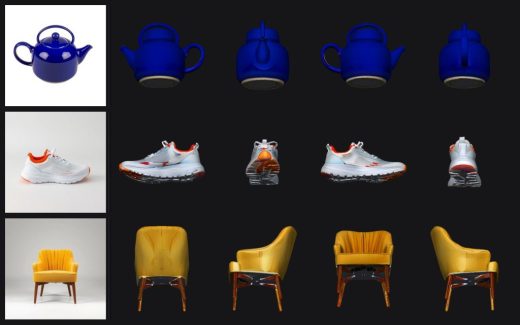 Hunyuan3D 2.1 无需 CUDA:更新新增 ROCm 和 PBR 纹理Hunyuan3D 2.1 的无 CUDA 硬件移植版于 2026 年 8 月 9 日更新,新增了此前完全没有的功能:通过 ROCm(Linux 和 Windows)支持 AMD 显卡,以及 PBR 纹理。之前的版本描述中明确声称
 HuggingFace 上的新模型 Minimax_h3_hybrid 解决 image-to-video 任务HuggingFace 上发布了模型 abakanai/Minimax_h3_hybrid,用于根据图像生成视频(image-to-video)。该模型于 2026 年 8 月 9 日出现,发布时已有 2111 次下载和 6 个“喜欢”标记。开发
 Robust-WAM 为基于视频生成器的 World-Action 模型添加语义稳定性来自 arXiv 的研究人员提出了 Robust-WAM——一种针对基于视频生成模型的 World-Action 模型的后训练方法。该工作解决的核心问题是:标准视频生成器在 VAE 空间中运行
 Vorch-Streamer 将头像生成转化为实时流式视频arXiv 发布了 Vorch-Streamer 的研究成果——一种后训练方法,能够根据文本实时生成带音频的视频。作者解决了两个问题:自回归生成长视频时的误差累积,以及同步
 VideoArgus 提出基于评分标准的视频生成与编辑统一评估系统研究人员在 arXiv 论文中介绍了 VideoArgus——一个用于评估生成及编辑视频质量的框架。与依赖固定内容的现有基准不同,VideoArgus 针对每个
 HelloWorld — 用于视频世界中与角色社交互动的模型研究人员推出了 HelloWorld——一种视频世界模型,用户可以与屏幕上的角色进行互动。按下按钮后,角色会对观众做出反应:转身、挥手、点头或说出一句简短的话。
- GVCCTurbo 为生成式视频和图像压缩提出码率规划方案arXiv 研究人员推出了 GVCCTurbo——一种规划器,它将生成式先验分布的昂贵更新与通过码本传输修正分离。它不再将采样器步数硬性绑定到
- SPADE 无需微调即可加速视频扩散 Transformer 中的注意力机制研究人员推出了 SPADE——一种稀疏注意力引擎,无需微调模型即可加速视频扩散 Transformer 的推理。该论文于 2026 年 8 月 4 日发布在 arXiv 上。作者提出了三个组件:规格
 SUV:将未来场景理解视为视频生成,实现端到端驾驶2026年8月4日,arXiv上发布了SUV——一个端到端驾驶框架,将未来场景理解视为视频生成任务。作者没有使用专门的预测模块,而是采用预训练视觉
 Token Radius Attention 无需微调即可加速扩散 Transformer 中的视频生成北京大学的研究人员提出了 Token Radius Attention (TRA)——一种在 Video Diffusion Transformers 中减少计算量的方法,无需重新训练模型。该论文于 2026 年 8 月 3 日发布在 arXiv 上。A
 EchoCache 利用音频信号能量加速声音驱动视频生成arXiv 报道了 EchoCache 的工作——一种用于 audio-driven video generation(A2V)的缓存方法。作者发现了现有方法中两类不一致:时间-语义不一致和计算-存储不一致。所提出的解决方案利用
 Sand AI 发布 MAGI-2-preview:HuggingFace 上的新开源 image-to-video 模型HuggingFace 上发布了 sand-ai/MAGI-2-preview —— Sand AI 的图像转视频生成器的预览版。该模型解决 image-to-video 任务,代码已开源。截至 2026 年 8 月 3 日发布时,其
 UniMoCa 将人体运动与相机控制统一为单一视觉表示研究人员推出了 UniMoCa——一种将人体运动和相机轨迹都转换为统一视觉表示(称为 Motion-Camera Visual Proxy,MCVP)的方法。该方法不再向模型输入异构信号
 MoRoute 提出用于多模态视频生成的动态层路由方案MoRoute 的研究人员发表了一篇论文,提出通过动态层路由将冻结的视觉-语言模型(VLM)与预训练的视频扩散 Transformer(DiT)相结合。该方法允许每个块
 ROAD 通过迁移判别模型知识降低 3D 生成训练成本ROAD(Reciprocal-Objective Alignment of Discriminative Semantics for 3D Shape Generation)论文作者提出一种方法,仅在训练阶段使用判别式 3D 模型,以降低生成的计算成本。关键
 Wan2.2 借助 DAR 方法学会根据动画网格渲染视频研究人员提出了 DAR 方法,可将预训练视频模型 Wan2.2 转变为由动画网格、相机轨迹和参考图像控制的渲染器。该方法不使用深度图(其中相机和物体的运动混合在一起)