Новости нейросетей: 3D, видео и языковые модели для своего железа
Короткие заметки о том, что изменилось у инструментов: вышла новая версия, сменилась лицензия, появилась поддержка другой платформы. Без пересказа пресс-релизов: если утверждение нельзя привязать к репозиторию, карточке модели или официальной странице, заметки не будет.
Материалы
96 материалов Новая модель h3-vbvr на HuggingFace решает задачу image-to-videoНа HuggingFace 18 августа 2026 года опубликована модель Patarapoom/h3-vbvr с задачей image-to-video. На момент публикации у неё 2434 загрузки и ни одн…
 SQuad ускоряет генерацию видео в Wan 2.2, сокращая внимание в 67 разАвторы SQuad представили метод дистилляции sub-quadratic attention для Video Diffusion Transformers. Вместо обучения модели с нуля они дистиллируют го…
 KeyID представила метод генерации видео с сохранением личности без дообученияНа arXiv опубликована работа KeyID — training-free фреймворк для identity-preserving video generation, который разделяет синтез динамики видео и внедр…
 AnyTalk генерирует 3D-анимацию речи для произвольных персонажей без анимационных данныхИсследователи представили AnyTalk — метод генерации 3D-анимации речи для произвольных персонажей, которому не нужны ни данные анимации, ни ручной ригг…
 ES3D добавляет компонентное редактирование 3D через семантические эмбеддингиНа arXiv опубликована работа ES3D — фреймворк для компонентного редактирования 3D-ассетов. Авторы предлагают встраивать семантику непосредственно в 3D…
 Audio-visual генерация получила метод ускорения с сохранением синхронизации звука и видеоАвторы работы Efficient Audio-Visual Generation via Synchrony-Aware Cross-Modal Sparse Attention предлагают метод ускорения инференса для моделей, кот…
- Qwen-Video-Edit превращает модель редактирования изображений в видеоредакторAlibaba представила Qwen-Video-Edit — подход, при котором instruction-based модель редактирования изображений Qwen-Image-Edit применяется к видео без…
 MegaParts масштабирует генерацию 3D-объектов по частям до 300 деталейИсследователи представили MegaParts — фреймворк для генерации 3D-объектов, разложенных на семантические части. В основе подхода — векторно-квантованны…
 V-RAE предлагает новый подход к латентным пространствам для генерации видеоНа arXiv опубликована работа V-RAE, в которой авторы пересматривают устройство латентных пространств видеоавтоэнкодеров. Вместо оптимизации латентного…
 Alaya-EVOKE представила метод генерации длинных интерактивных миров с линейным масштабированиемНа arXiv опубликована работа Alaya-EVOKE, в которой авторы решают задачу генерации длинных интерактивных миров. Они выносят состояние сцены во внешний…
 LTX-2.5 вышла на HuggingFace с задачей text-to-videoНа HuggingFace опубликована модель comfyicu/LTX-2.5 с задачей text-to-video. Дата публикации — 13.08.2026, у модели 3630 загрузок. Подробности — на ст…
 На HuggingFace появилась модель LTX-2.5 с задачей text-to-videoНа HuggingFace опубликована модель yuvraj108c/LTX-2.5 с задачей text-to-video. Дата публикации — 12 августа 2026 года. На момент заметки у модели 1445…
 Заметка о новом методе удаления отражений из видео на основе диффузииИсследователи представили работу From Synthesis to Removal: Physics-Grounded Reflection Simulation and Diffusion-Based Video Dereflection, опубликован…
 LTX-Video и CogVideoX получают новый метод zero-shot генерации субтитров через синтетическоеИсследователи опубликовали на arXiv работу Watching Synthetic Videos: Aligning Cross-modal Representations with Visual Synthesis for Zero-shot Video C…
 Minimax-H3-fl2va-ref2va-hybrid-models: новая text-to-video модель на HuggingFaceНа HuggingFace 11 августа 2026 года опубликована модель smhfacct/Minimax-H3-fl2va-ref2va-hybrid-models с задачей text-to-video. На момент публикации у…
- Latent-to-4D генерирует 4D-сцены напрямую из латентов видео без промежуточного RGBАвторы работы Beyond Pixels: From Video Priors to 4D Worlds предлагают метод Latent-to-4D, который минует этап восстановления RGB-видео и предсказывае…
 Sci-VBench: бенчмарк научной достоверности видео от генеративных моделейАвторы Sci-VBench представили бенчмарк для оценки генерации видео в научных областях. Он включает 1 253 экспертно размеченных примера по 60 дисциплина…
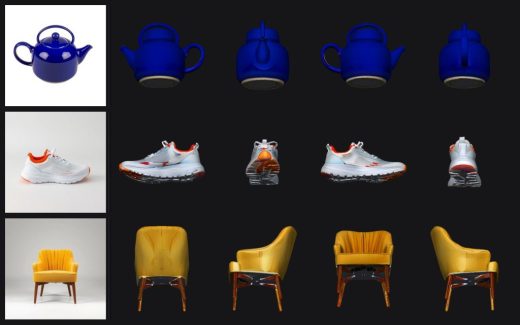 Hunyuan3D 2.1 без CUDA: обновление добавило ROCm и PBR-текстурированиеПорт Hunyuan3D 2.1 на железо без CUDA обновился 9 августа 2026 года, и в нём появилось то, чего раньше не было совсем: поддержка видеокарт AMD через R…
 Новая модель Minimax_h3_hybrid на HuggingFace решает задачу image-to-videoНа HuggingFace опубликована модель abakanai/Minimax_h3_hybrid, предназначенная для генерации видео по изображению (image-to-video). Модель появилась 9…
 Robust-WAM добавляет семантическую устойчивость в World-Action Models на базе видеогенераторовИсследователи из arXiv представили Robust-WAM — метод пост-тренировки для World-Action Models, построенных на основе видеогенеративных моделей. Основн…
 Vorch-Streamer превращает генерацию аватаров в потоковое видео реального времениarXiv опубликовал работу Vorch-Streamer — метод посттренировки, позволяющий генерировать видео с аудио по тексту в реальном времени. Авторы решают две…
 VideoArgus предлагает единую систему оценки генерации и редактирования видео на основе рубрикИсследователи представили VideoArgus — фреймворк для оценки качества сгенерированных и отредактированных видео, описанный в работе на arXiv. В отличие…
 HelloWorld — модель для социального взаимодействия с персонажами в видеомирахИсследователи представили HelloWorld — модель видеомира, в которой пользователь может взаимодействовать с персонажами на экране. По нажатию кнопки пер…
- GVCCTurbo предлагает планировать битрейт для генеративного сжатия видео и изображений безarXiv Исследователи представили GVCCTurbo — планировщик, который отделяет дорогостоящие обновления генеративного априорного распределения от передачи…
- SPADE ускоряет внимание в видео-диффузионных трансформерах без переобученияИсследователи представили SPADE — движок разреженного внимания, который ускоряет инференс видео-диффузионных трансформеров без дообучения модели. Рабо…
 SUV: будущее сцены как генерация видео для сквозного вождения4 августа 2026 года на arXiv появилась работа SUV — фреймворк сквозного вождения, который представляет понимание будущей сцены как задачу генерации ви…
 Token Radius Attention ускоряет генерацию видео в диффузионных трансформерах без дообученияИсследователи из Пекинского университета представили Token Radius Attention (TRA) — метод, который сокращает объём вычислений в Video Diffusion Transf…
 EchoCache ускоряет генерацию видео по звуку за счёт энергии аудиосигналаarXiv сообщает о работе EchoCache — методе кэширования для audio-driven video generation (A2V). Авторы выявили два типа рассогласования в существующих…
 MAGI-2-preview от Sand AI: новая открытая модель image-to-video на HuggingFaceНа HuggingFace опубликована модель sand-ai/MAGI-2-preview — предварительная версия генератора видео по изображению от Sand AI. Модель решает задачу im…
 UniMoCa объединяет управление движением человека и камеры в едином визуальном представленииИсследователи представили UniMoCa — метод, который переводит и движение человека, и траекторию камеры в общее визуальное представление под названием M…